<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://jisooryu99.github.io//feed.xml" rel="self" type="application/atom+xml" /><link href="https://jisooryu99.github.io//" rel="alternate" type="text/html" /><updated>2024-08-13T08:45:06+09:00</updated><id>https://jisooryu99.github.io//feed.xml</id><title type="html">Jisoo Blog</title><subtitle>기록하기</subtitle><author><name>Jisoo Ryu</name></author><entry><title type="html">[알고리즘] 다이나믹 프로그래밍 (Dynamic Programming, 동적 계획법)</title><link href="https://jisooryu99.github.io//%EC%95%8C%EA%B3%A0%EB%A6%AC%EC%A6%98/%EB%8B%A4%EC%9D%B4%EB%82%98%EB%AF%B9-%ED%94%84%EB%A1%9C%EA%B7%B8%EB%9E%98%EB%B0%8D/" rel="alternate" type="text/html" title="[알고리즘] 다이나믹 프로그래밍 (Dynamic Programming, 동적 계획법)" /><published>2022-03-12T00:00:00+09:00</published><updated>2022-03-12T00:00:00+09:00</updated><id>https://jisooryu99.github.io//%EC%95%8C%EA%B3%A0%EB%A6%AC%EC%A6%98/%EB%8B%A4%EC%9D%B4%EB%82%98%EB%AF%B9%20%ED%94%84%EB%A1%9C%EA%B7%B8%EB%9E%98%EB%B0%8D</id><content type="html" xml:base="https://jisooryu99.github.io//%EC%95%8C%EA%B3%A0%EB%A6%AC%EC%A6%98/%EB%8B%A4%EC%9D%B4%EB%82%98%EB%AF%B9-%ED%94%84%EB%A1%9C%EA%B7%B8%EB%9E%98%EB%B0%8D/"><![CDATA[<h2 id="dp란-하나의-문제는-단-한-번만-풀도록-하는-알고리즘">DP란 ‘하나의 문제는 단 한 번만 풀도록 하는 알고리즘’</h2>
<p>다이나믹 프로그래밍은 메모리 공간을 약간 더 사용해서 연산 속도를 비약적으로 증가시키는 방법<br />
이미 진행이 되었던 연산이 반복되는 결점을 보안하기 위해 고안함.<br />
=&gt; 여러개의 소문제로 분할하여 각 소문제의 해결안을 바탕으로 주어진 문제를 해결, 이때 각 소문제는 다시 여러개의 소문제로 분할 가능</p>

<p>다음 2가지 조건을 만족할 때 사용 가능</p>
<ul>
  <li>큰 문제를 작은 문제로 나눌 수 있다.</li>
  <li>작은 문제에서 구한 정답은 그것을 포함하는 큰 문제에서도 동일하다</li>
</ul>

<p>위 조건을 만족하는 대표적인 문제가 피보나치 수열<br />
(피보나치 수열은 특정한 숫자를 구하기 위해 그 앞에 있는 숫자와 두 칸 앞에 있는 숫자의 합)<br />
피보나치 수열의 점화식 : D[i] = D[i-1] + D[i-2]</p>

<p><mark> <재귀함수를 이용한="" 피보나치="" 수열="" 구현="">
<script src="https://gist.github.com/JisooRyu99/882085e76a716a1ecb86b90d65397be0.js"></script></재귀함수를></mark></p>

<p><mark> <반복문을 이용한="" 피보나치="" 수열="" 구현="">
<script src="https://gist.github.com/JisooRyu99/18b54c0b2e7413eaac1ffcb6b2032857.js"></script></반복문을></mark></p>

<h3 id="동적-계획법">동적 계획법</h3>

<ol>
  <li>Memoization (Top-Down, 하향식)</li>
</ol>

<p>하향식(Top-Down) 경우 하위 문제에 대하여 정답을 계산했는지 확인해가며 문제를 자연스럽게 풀어가는 방법
&lt; 동일 계산 반복시 &gt;<br />
이전 계산값을 메모리에 저장하여 (메모리 공간을 약간 더 사용) (캐싱이라고도 함)</p>

<script src="https://gist.github.com/JisooRyu99/c090f9813bfb0db28abcf4dfd57e3936.js"></script>

<ol>
  <li>Tabulation (Bottom-up, 상향식)</li>
</ol>

<p>최초 값부터 차례대로 계산해 나가는 방식<br />
<script src="https://gist.github.com/JisooRyu99/bc60eef30a81f72a5478e6fd00eaf601.js"></script></p>]]></content><author><name>Jisoo Ryu</name></author><category term="알고리즘" /><summary type="html"><![CDATA[DP란 ‘하나의 문제는 단 한 번만 풀도록 하는 알고리즘’ 다이나믹 프로그래밍은 메모리 공간을 약간 더 사용해서 연산 속도를 비약적으로 증가시키는 방법 이미 진행이 되었던 연산이 반복되는 결점을 보안하기 위해 고안함. =&gt; 여러개의 소문제로 분할하여 각 소문제의 해결안을 바탕으로 주어진 문제를 해결, 이때 각 소문제는 다시 여러개의 소문제로 분할 가능]]></summary></entry><entry><title type="html">[자료구조] Heap</title><link href="https://jisooryu99.github.io//%EC%9E%90%EB%A3%8C%EA%B5%AC%EC%A1%B0/Heap/" rel="alternate" type="text/html" title="[자료구조] Heap" /><published>2022-02-16T00:00:00+09:00</published><updated>2022-02-16T00:00:00+09:00</updated><id>https://jisooryu99.github.io//%EC%9E%90%EB%A3%8C%EA%B5%AC%EC%A1%B0/Heap</id><content type="html" xml:base="https://jisooryu99.github.io//%EC%9E%90%EB%A3%8C%EA%B5%AC%EC%A1%B0/Heap/"><![CDATA[<h1 id="힙이란">힙이란?</h1>
<ul>
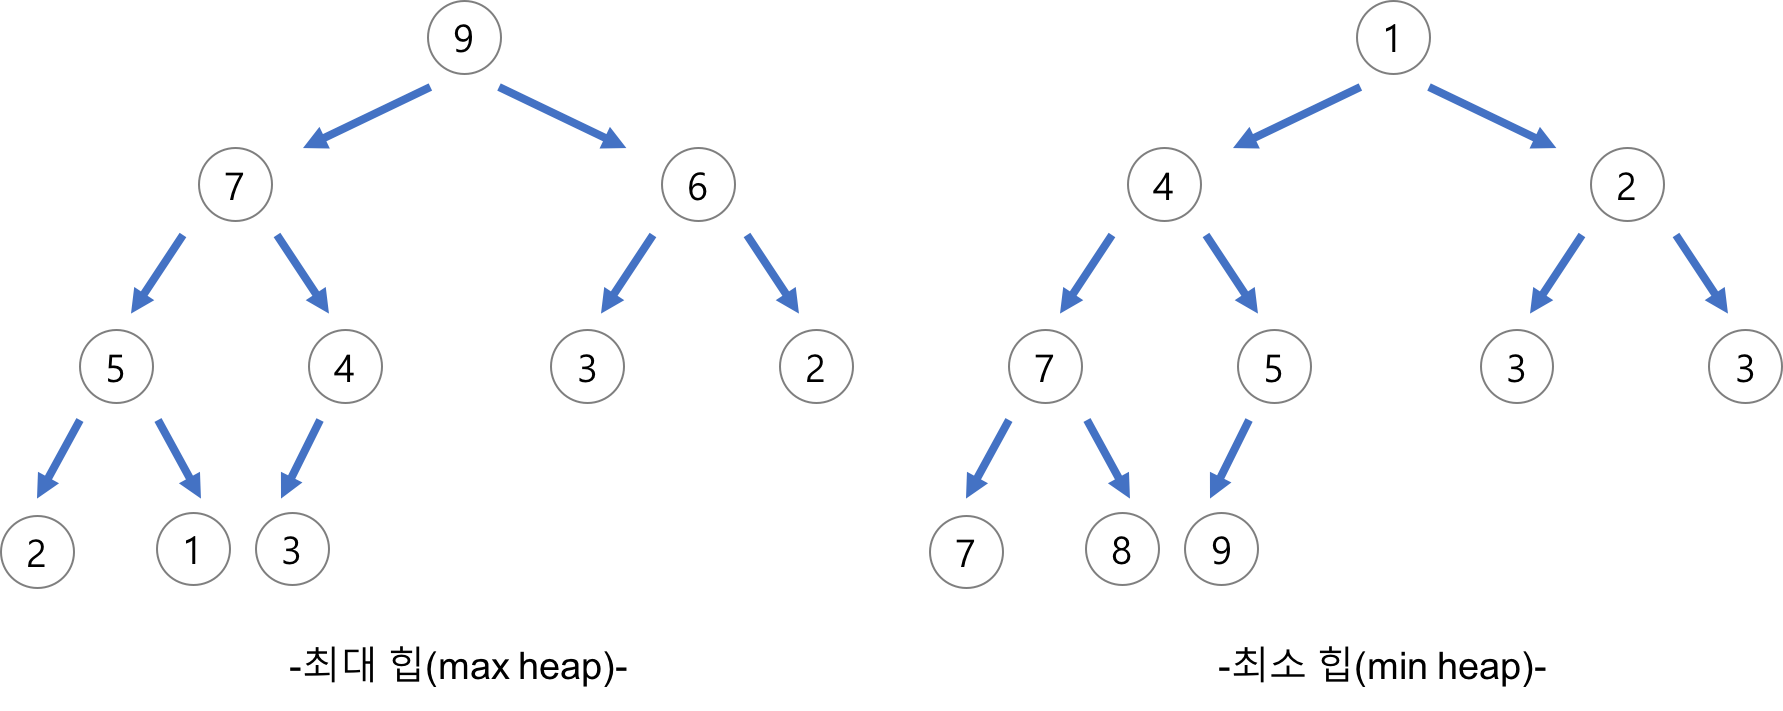
  <li>여러 개의 값들 중에서 최대값이나 최소값을 빠르게 찾아내도록 만들어진 자료구조</li>
  <li>완전 이진 트리의 일종으로 우선순위 큐를 위하여 만들어진 자료구조</li>
  <li>힙 트리에서는 중복된 값을 허용</li>
</ul>

<p><img src="https://user-images.githubusercontent.com/90206705/154285420-1dccfdea-a778-492c-a85e-5517408b5305.png" alt="types-of-heap" /></p>

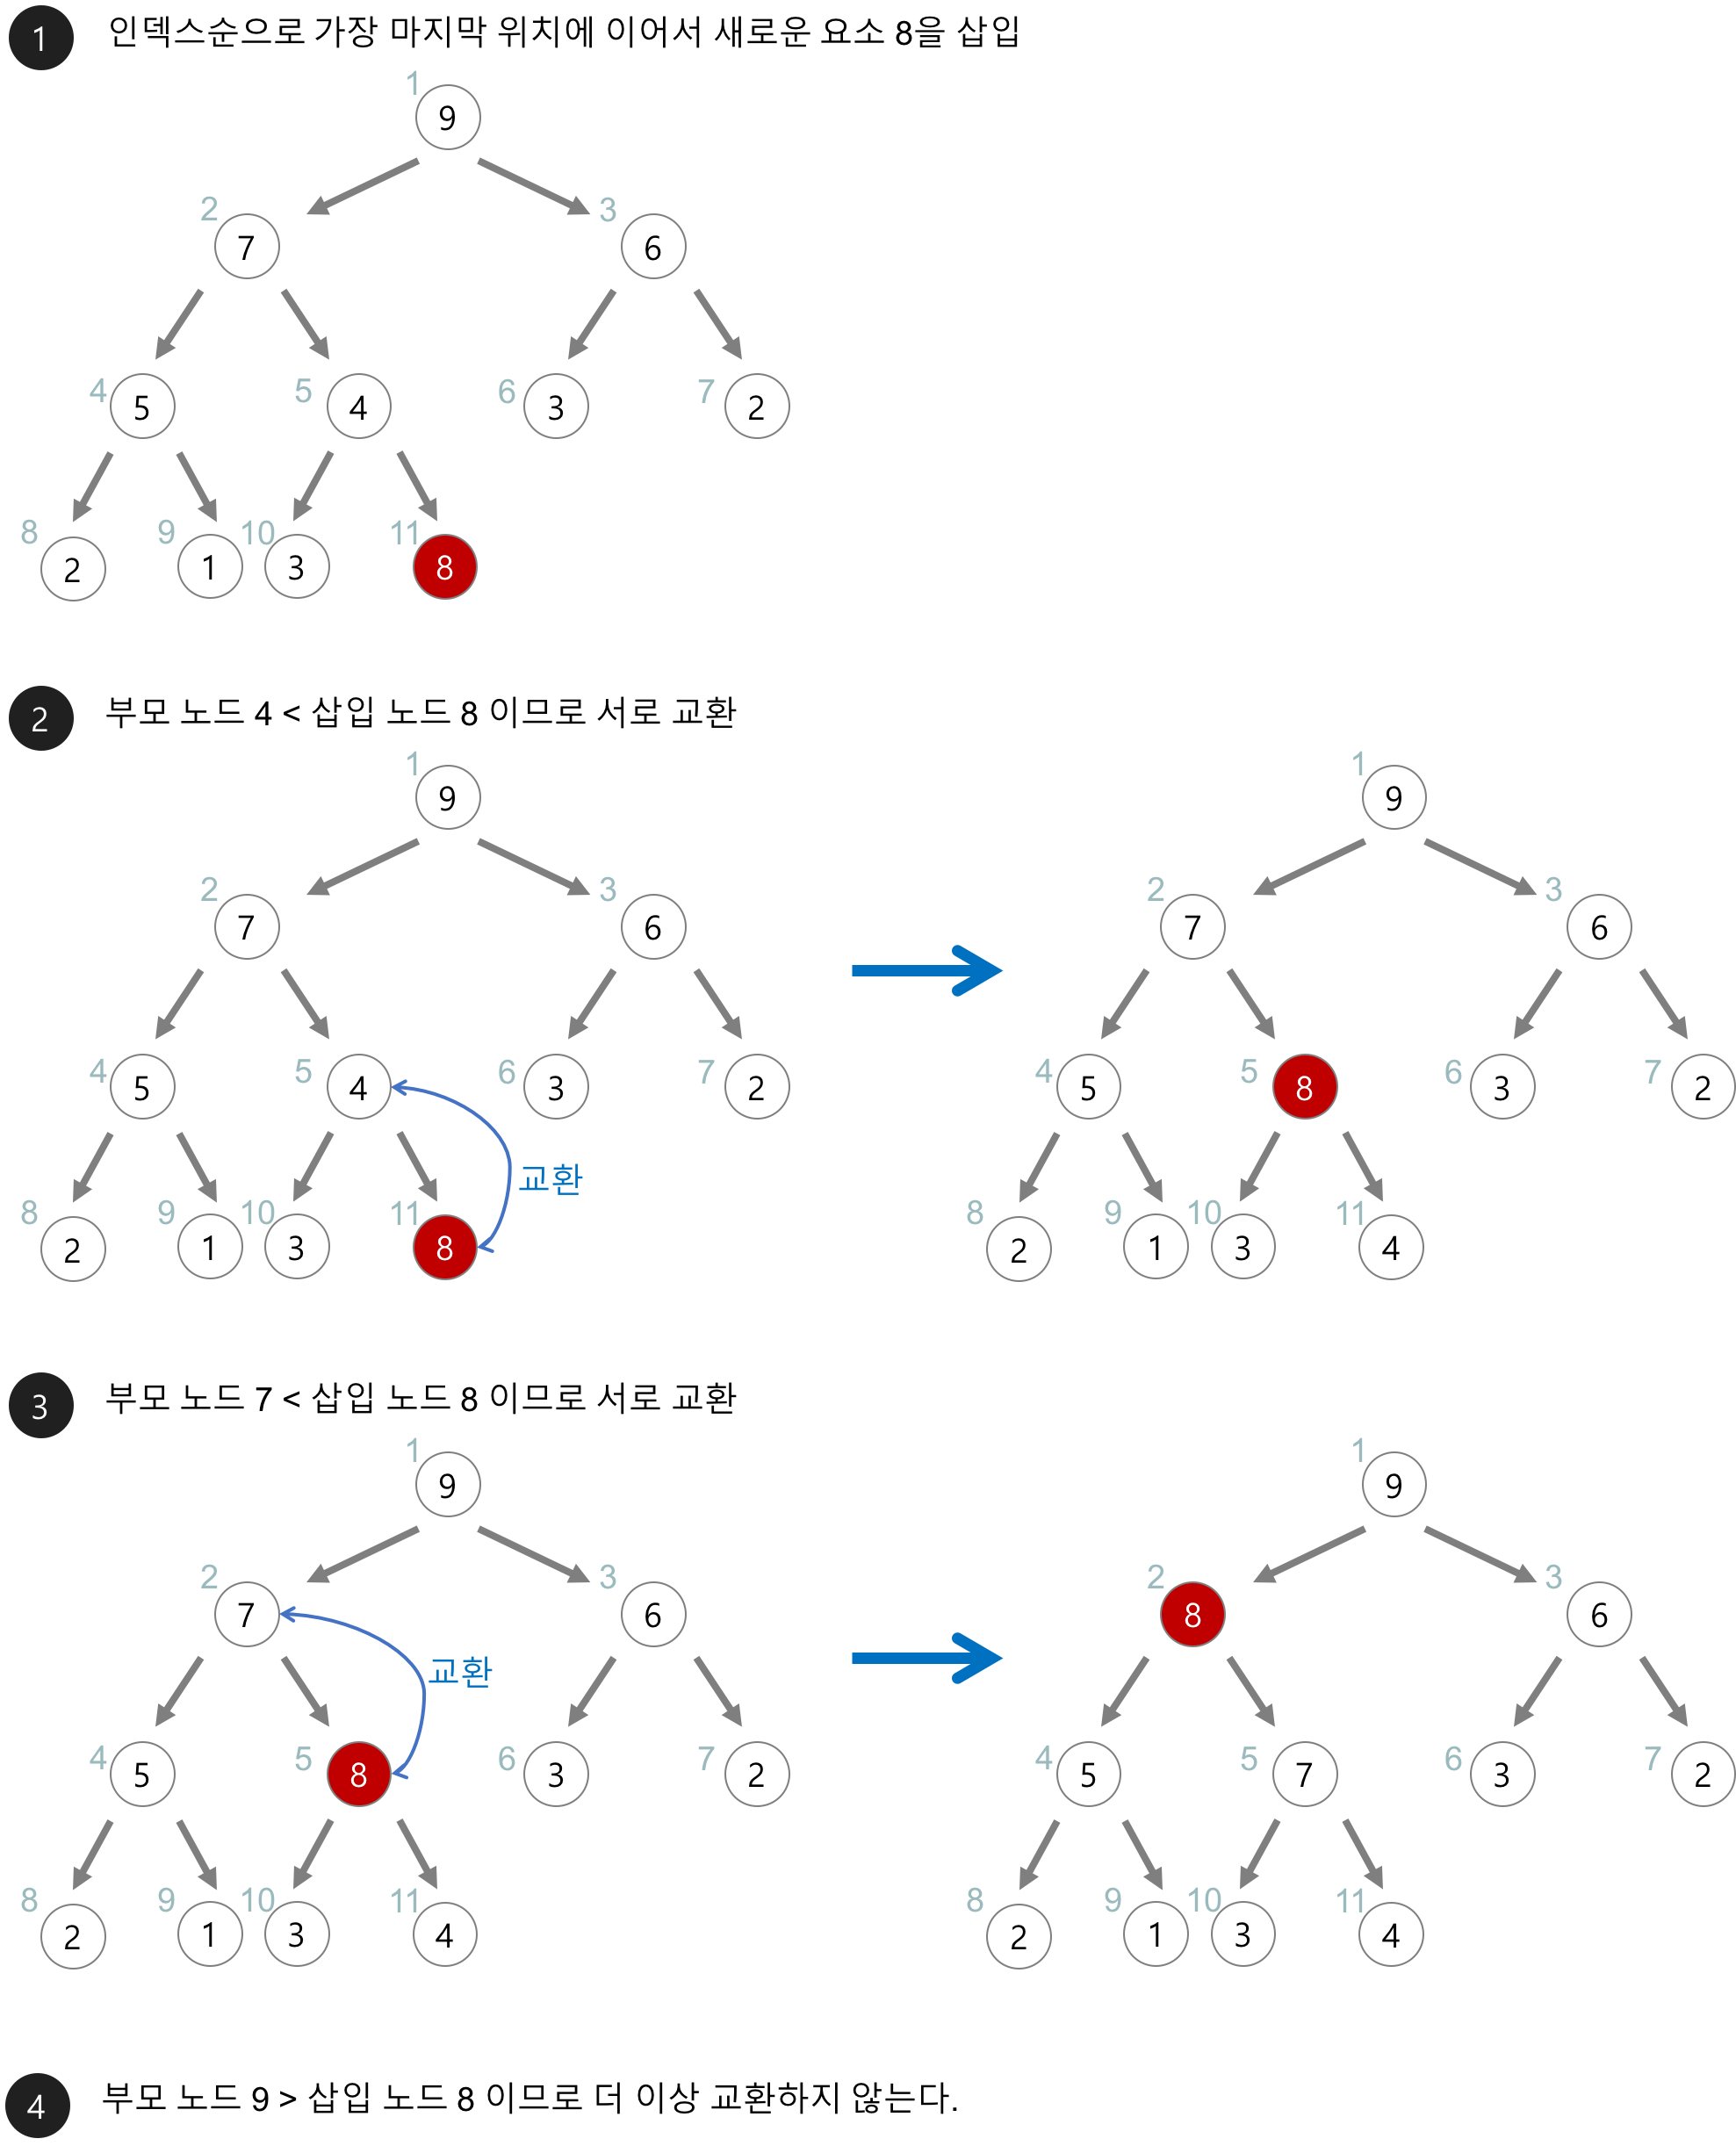
<h4 id="-heap-삽입-">&lt; heap 삽입 &gt;</h4>
<ol>
  <li>힙에 새로운 요소가 들어오면, 일단 새로운 노드를 힙의 마지막 노드에 이어서 삽입</li>
  <li>새로운 노드를 부모 노드들과 교환해서 힙의 성질 만족</li>
</ol>

<p><img src="https://user-images.githubusercontent.com/90206705/154286281-4d5db516-ee48-474b-845a-d2ae6d21a964.png" alt="maxheap-insertion" /></p>

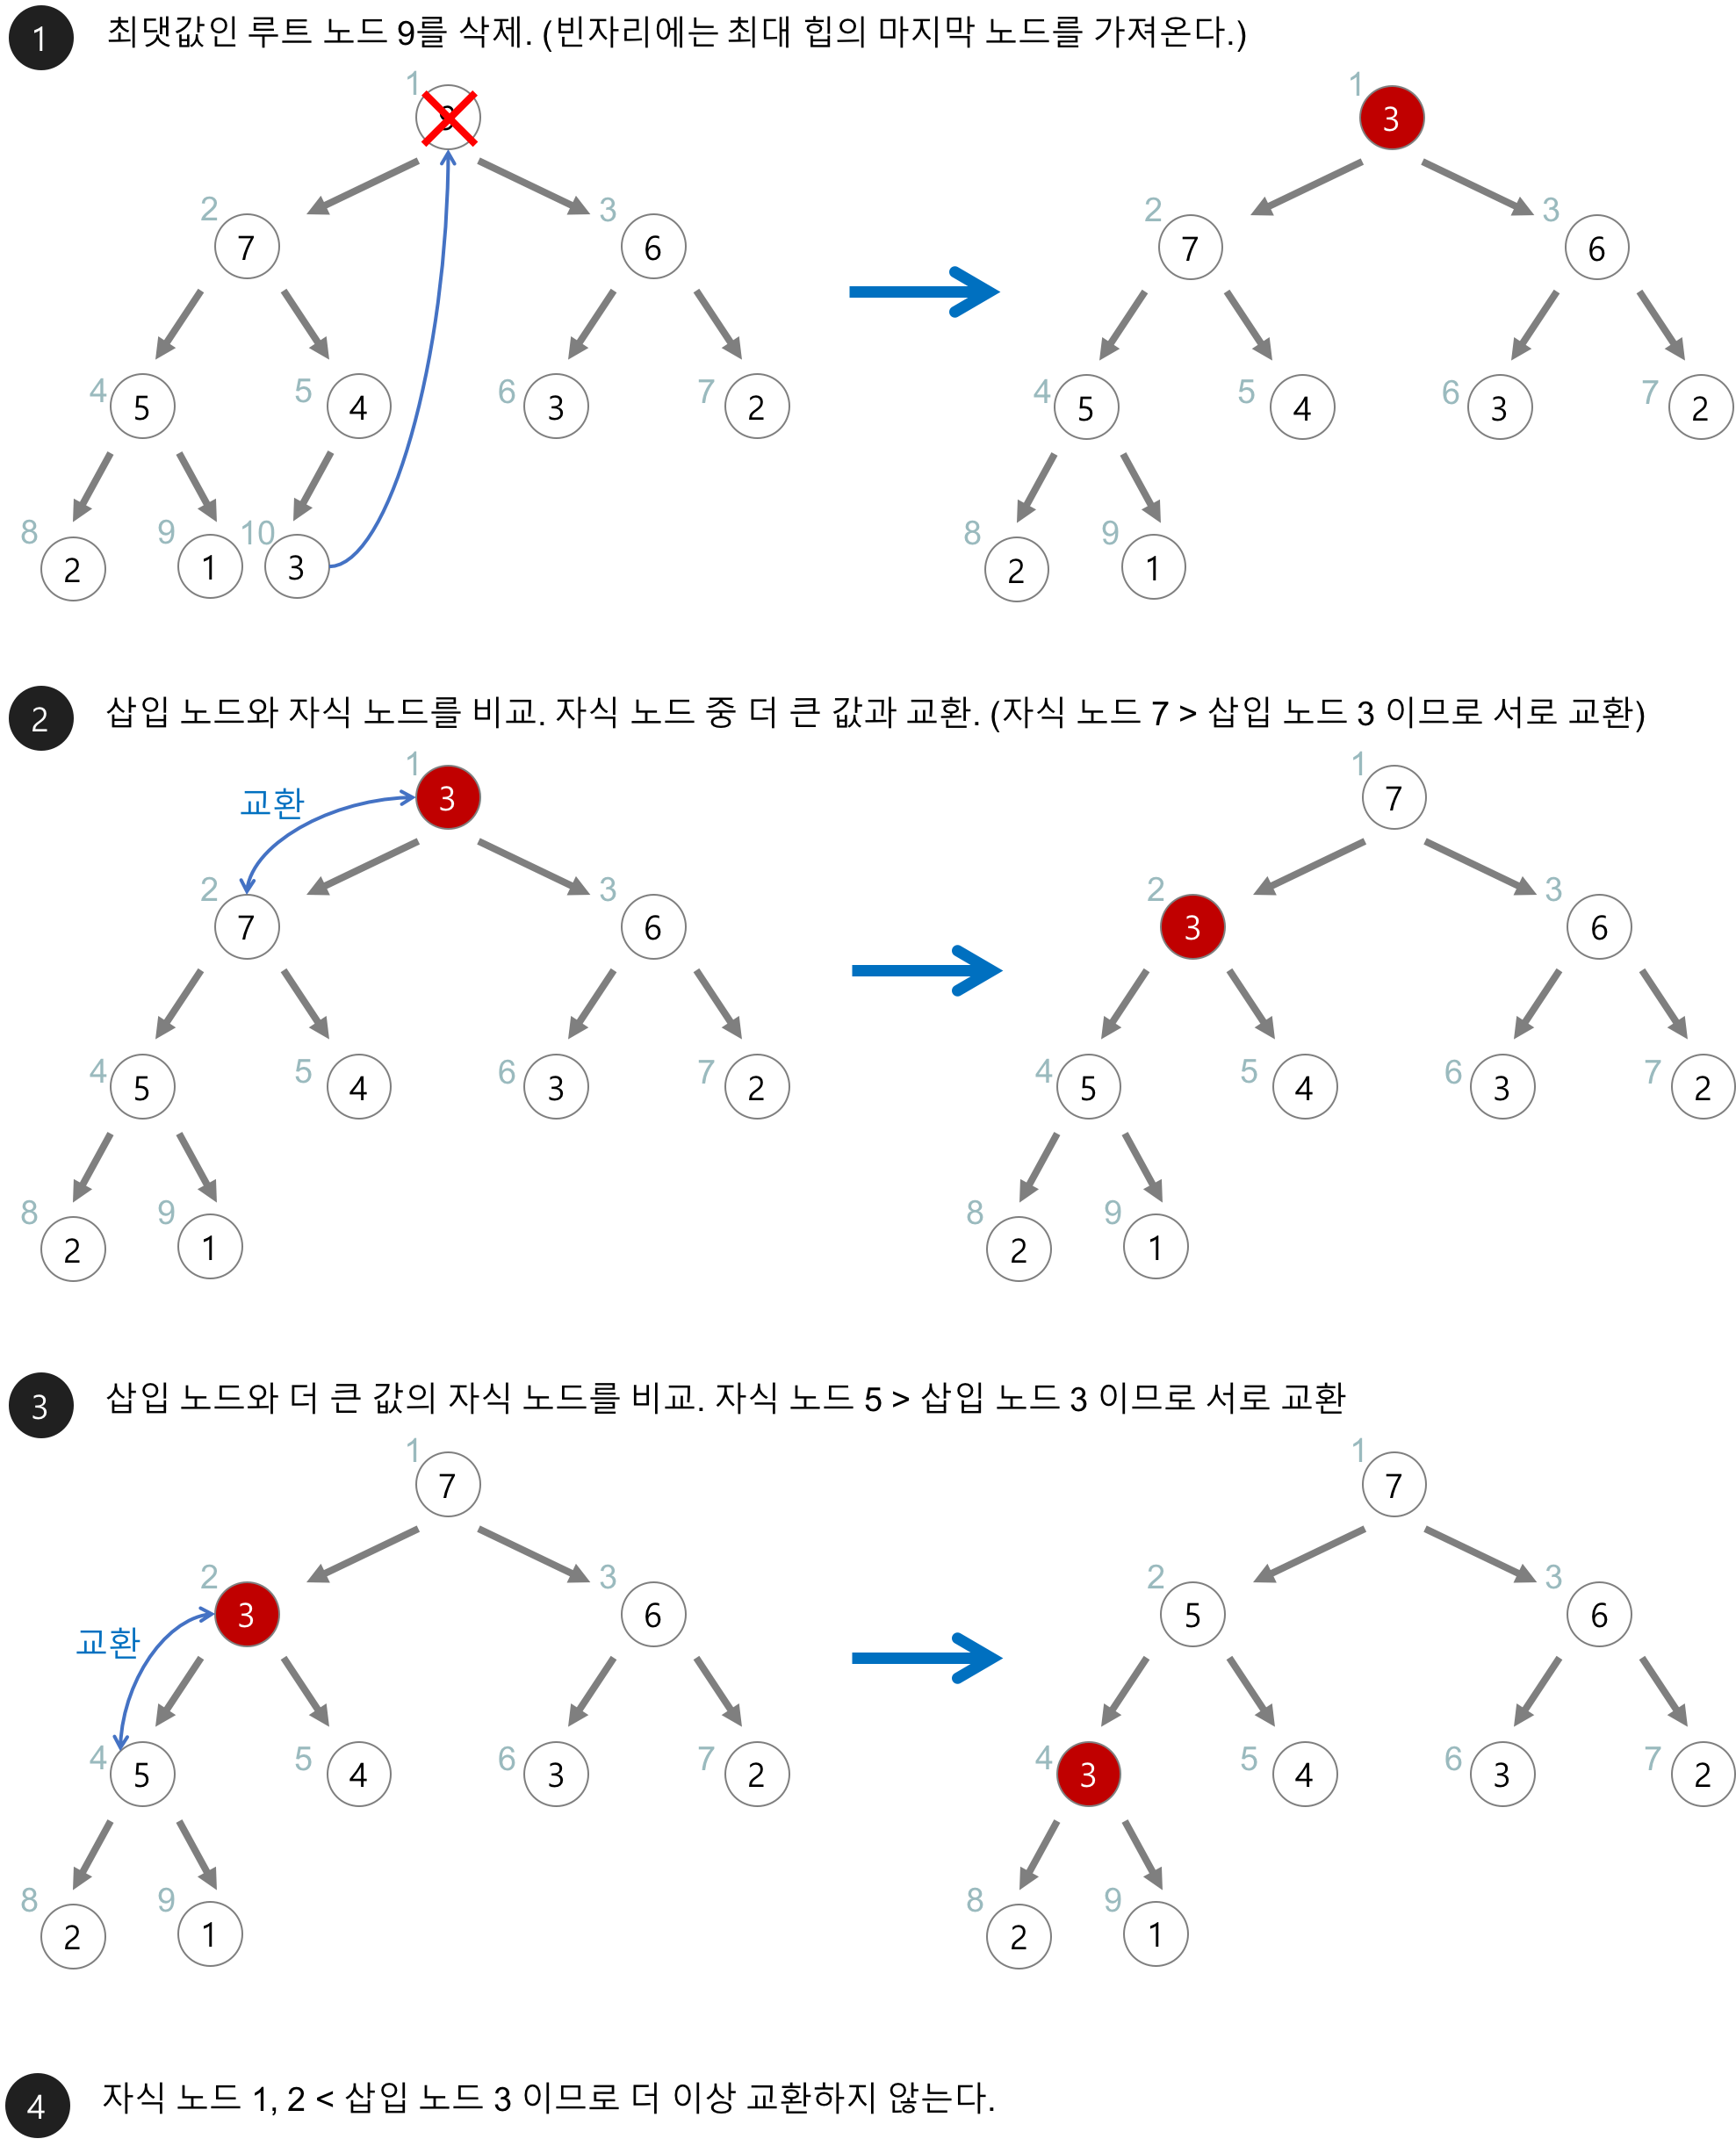
<h4 id="-heap-삭제-">&lt; heap 삭제 &gt;</h4>
<ol>
  <li>최대 힙에서 최대값은 root node이므로 rote note가 삭제</li>
  <li>삭제된 root node에는 heap의 마지막 node를 가져옴</li>
  <li>heap을 재구성</li>
</ol>

<p><img src="https://user-images.githubusercontent.com/90206705/154286801-d7de1980-9a79-47a5-b5b4-4f45def7cafd.png" alt="maxheap-delete" /></p>

<h3 id="deque-heapq-차이-및-사용법">deque, heapq 차이 및 사용법</h3>

<ul>
  <li>heapq 모듈은 최소 heap을 지원하는 모듈로 직접 최소 힙을 구현하지 않아도 되는 장점이 있음.</li>
</ul>

<blockquote>
  <p>deque</p>
  <ul>
    <li>선입선출</li>
    <li>BFS</li>
  </ul>

  <p>from collections import deque  <br />
q = deque()   <br />
q.append(‘l’)   <br />
q.popleft()</p>
</blockquote>

<blockquote>
  <p>heapq</p>
  <ul>
    <li>최소힙, 최대힙</li>
    <li>최소값이나 최대값을 빨리 찾아야 할 때</li>
  </ul>

  <p>from heapq import heappush, heappop, heapify   <br />
q=[]   <br />
heappush(q,1)</p>
  <blockquote>
    <ul>
      <li>힙 상태를 유지하며, 데이터 삽입  <br />
heappop(q)
        <ol>
          <li>가장 작은 원소를 빼냄</li>
          <li>나머지 원소가 힙을 유지하도록 정렬
heapify(arr)</li>
        </ol>
      </li>
      <li>주어진 리스트를 heap 정렬할 때 사용 (ex- heapq.heapify(list))</li>
    </ul>
  </blockquote>
</blockquote>]]></content><author><name>Jisoo Ryu</name></author><category term="자료구조" /><summary type="html"><![CDATA[힙이란? 여러 개의 값들 중에서 최대값이나 최소값을 빠르게 찾아내도록 만들어진 자료구조 완전 이진 트리의 일종으로 우선순위 큐를 위하여 만들어진 자료구조 힙 트리에서는 중복된 값을 허용]]></summary></entry><entry><title type="html">[알고리즘] 에라토스테네스의 체</title><link href="https://jisooryu99.github.io//%EC%95%8C%EA%B3%A0%EB%A6%AC%EC%A6%98/%EC%97%90%EB%9D%BC%ED%86%A0%EC%8A%A4%ED%85%8C%EB%84%A4%EC%8A%A4%EC%9D%98-%EC%B2%B4/" rel="alternate" type="text/html" title="[알고리즘] 에라토스테네스의 체" /><published>2022-02-10T00:00:00+09:00</published><updated>2022-02-10T00:00:00+09:00</updated><id>https://jisooryu99.github.io//%EC%95%8C%EA%B3%A0%EB%A6%AC%EC%A6%98/%EC%97%90%EB%9D%BC%ED%86%A0%EC%8A%A4%ED%85%8C%EB%84%A4%EC%8A%A4%EC%9D%98%20%EC%B2%B4</id><content type="html" xml:base="https://jisooryu99.github.io//%EC%95%8C%EA%B3%A0%EB%A6%AC%EC%A6%98/%EC%97%90%EB%9D%BC%ED%86%A0%EC%8A%A4%ED%85%8C%EB%84%A4%EC%8A%A4%EC%9D%98-%EC%B2%B4/"><![CDATA[<h1 id="아라토스테네스의-체-란">아라토스테네스의 체 란?</h1>
<p>소수를 판별하는 알고리즘으로 소수들을 대량으로 빠르고 정확하게 구하는 방법</p>

<h3 id="-아라토스테네스의-체-원리-">&lt; 아라토스테네스의 체 원리 &gt;</h3>

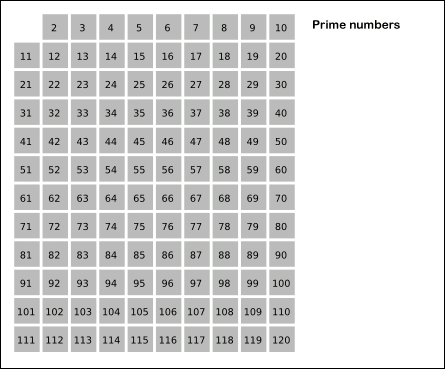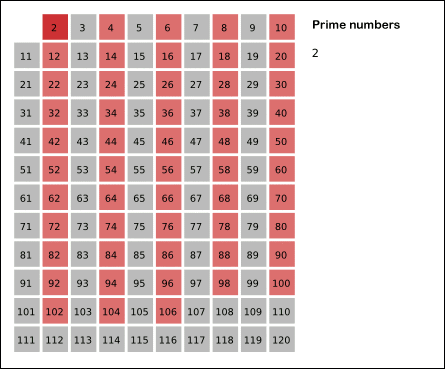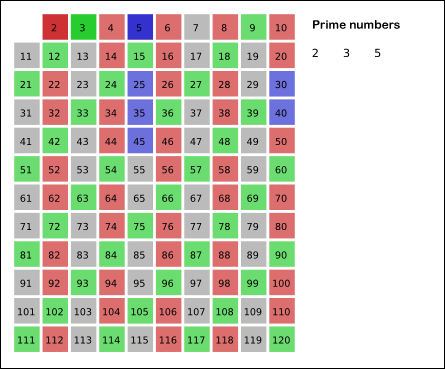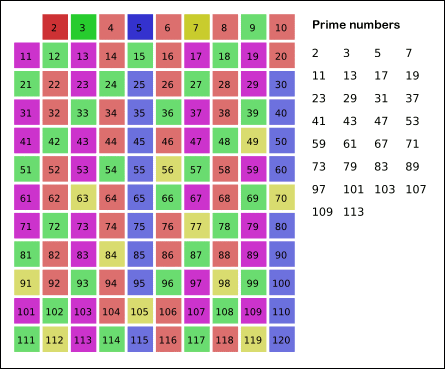
<ol>
  <li>2부터 소수를 구하고자 하는 구간의 모든 수를 나열한다. 그림에서 회색 사각형으로 두른 수들이 여기에 해당한다.</li>
  <li>2는 소수이므로 오른쪽에 2를 쓴다. (빨간색)</li>
  <li>자기 자신을 제외한 2의 배수를 모두 지운다.</li>
  <li>남아있는 수 가운데 3은 소수이므로 오른쪽에 3을 쓴다. (초록색)</li>
  <li>자기 자신을 제외한 3의 배수를 모두 지운다.</li>
  <li>남아있는 수 가운데 5는 소수이므로 오른쪽에 5를 쓴다. (파란색)</li>
  <li>자기 자신을 제외한 5의 배수를 모두 지운다.</li>
  <li>남아있는 수 가운데 7은 소수이므로 오른쪽에 7을 쓴다. (노란색)</li>
  <li>자기 자신을 제외한 7의 배수를 모두 지운다.</li>
  <li>위의 과정을 반복하면 구하는 구간의 모든 소수가 남는다.</li>
</ol>

<p><img src="https://user-images.githubusercontent.com/90206705/153433743-4e17dfde-5bd5-49b2-8b62-c382acb1124f.gif" alt="Sieve_of_Eratosthenes_animation" /></p>

<h3 id="-구현하는-방법-">&lt; 구현하는 방법 &gt;</h3>

<script src="https://gist.github.com/JisooRyu99/c599af7a30f581f73e63d8332503f8bd.js"></script>]]></content><author><name>Jisoo Ryu</name></author><category term="알고리즘" /><summary type="html"><![CDATA[아라토스테네스의 체 란? 소수를 판별하는 알고리즘으로 소수들을 대량으로 빠르고 정확하게 구하는 방법]]></summary></entry><entry><title type="html">[자료구조] stack &amp;amp; queue</title><link href="https://jisooryu99.github.io//%EC%9E%90%EB%A3%8C%EA%B5%AC%EC%A1%B0/stack&queue/" rel="alternate" type="text/html" title="[자료구조] stack &amp;amp; queue" /><published>2022-01-14T00:00:00+09:00</published><updated>2022-01-14T00:00:00+09:00</updated><id>https://jisooryu99.github.io//%EC%9E%90%EB%A3%8C%EA%B5%AC%EC%A1%B0/stack&amp;queue</id><content type="html" xml:base="https://jisooryu99.github.io//%EC%9E%90%EB%A3%8C%EA%B5%AC%EC%A1%B0/stack&amp;queue/"><![CDATA[<h1 id="stack-lifo">Stack (LIFO)</h1>
<hr />
<h3 id="-stack특징-"><strong>&lt; stack특징 &gt;</strong></h3>

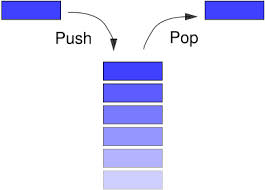
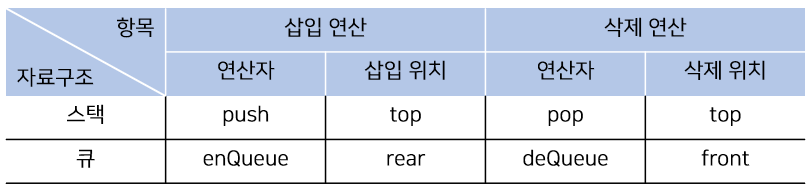
<p><img src="https://user-images.githubusercontent.com/90206705/149521899-41f95b57-ed56-4771-91e4-eefdcc1e434e.jpg" alt="stack" /></p>

<ul>
  <li>같은 구조와 크기의 자료를 정해진 방향으로만 쌓을 수 있음</li>
  <li>top에는 가장 위에 있는 자료, 가장 최근에 들어온 자료</li>
  <li>stack에서 자료를 삭제할 때도 top을 통해서만 가능</li>
  <li>top을 통해 삽입하는 연산 -&gt; ‘push’</li>
  <li>top을 통해 삭제하는 연산 -&gt; ‘pop’</li>
  <li>비어있는 stack에서 원소 추출할 때 -&gt; ‘stack underflow’</li>
  <li>스택이 넘치는 경우 -&gt; ‘stack overflow’
<br /><br /></li>
  <li>stack은 순서에 따라 자료가 쌓여서 가장 마지막에 삽입된 자료가 가장 먼저 삭제 <br />
<strong>–&gt; LIFO (Last-In-First-Out) 구조</strong>
<br /></li>
</ul>

<h3 id="-stack의-활용-예시-"><strong>&lt; stack의 활용 예시 &gt;</strong></h3>
<ul>
  <li>역순 문자열 만들기</li>
  <li>후위 표기법 계산</li>
  <li>수식의 괄호 검사 (연산자 우선순위 표현을 위한 괄호 검사)
<br />
<br /></li>
</ul>

<h1 id="queue-fifo">Queue (FIFO)</h1>
<hr />

<h3 id="-queue특징-"><strong>&lt; queue특징 &gt;</strong></h3>

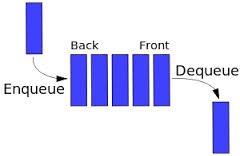
<p><img src="https://user-images.githubusercontent.com/90206705/149521916-e7bf9539-e7d7-4422-a1cf-cead1ccc0e82.jpg" alt="queue" /></p>

<p><strong>한쪽 끝에서 삽입 작업이, 다른 쪽 끝에서 삭제 작업이 양쪽으로 이루어짐.</strong> <br />
<strong>queue의 rear에서 이루어지는 삽입연산 -&gt; enQueue</strong> <br />
<strong>front에서 이루어지는 삭제연산 -&gt; deQueue</strong> <br /></p>

<ul>
  <li>queue 의 가장 첫 원소 -&gt; front</li>
  <li>가장 끝 원소 -&gt; rear</li>
  <li>rear로 들어오지만 front부터 빠지는 특성</li>
  <li>가장 먼저 들어온 front 원소가 가장 먼저 삭제 
__ -&gt; front 원소는 가장 먼저 queue에 들어왔던 첫 번째 원소가 되는 것이며, rear 원소는 가장 늦게 queue에 들어온 마지막 원소가 되는 것</li>
</ul>

<p><br /></p>

<h3 id="-queue의-활용-예시-"><strong>&lt; queue의 활용 예시 &gt;</strong></h3>
<p>주로 데이터가 입력된 시간 순서대로 처리해야 할 필요가 있는 상황</p>
<ul>
  <li>너비 우선 탐색 (BFS, Breadth-First Search) 구현</li>
</ul>

<hr />

<h3 id="-stack과-queue의-비교-">&lt; stack과 queue의 비교 &gt;</h3>
<p><img src="https://user-images.githubusercontent.com/90206705/149522118-4df4c75b-5369-432a-9bd4-447995e06d38.png" alt="img1 daumcdn" /></p>]]></content><author><name>Jisoo Ryu</name></author><category term="자료구조" /><category term="minimal mistakes" /><category term="jekyll" /><category term="blog" /><summary type="html"><![CDATA[Stack (LIFO) &lt; stack특징 &gt;]]></summary></entry><entry><title type="html">[자료구조] Hash</title><link href="https://jisooryu99.github.io//%EC%9E%90%EB%A3%8C%EA%B5%AC%EC%A1%B0/Hash/" rel="alternate" type="text/html" title="[자료구조] Hash" /><published>2022-01-11T00:00:00+09:00</published><updated>2022-01-11T00:00:00+09:00</updated><id>https://jisooryu99.github.io//%EC%9E%90%EB%A3%8C%EA%B5%AC%EC%A1%B0/Hash</id><content type="html" xml:base="https://jisooryu99.github.io//%EC%9E%90%EB%A3%8C%EA%B5%AC%EC%A1%B0/Hash/"><![CDATA[<p><br /></p>

<h1 id="자료구조-hash">[자료구조] Hash</h1>
<h2 id="-hash-table-이란-">[ Hash Table 이란? ]</h2>
<p><img src="https://user-images.githubusercontent.com/90206705/148952795-fbc17000-7930-4d1d-b07a-7972cb3f40a6.png" alt="img1 daumcdn" /></p>

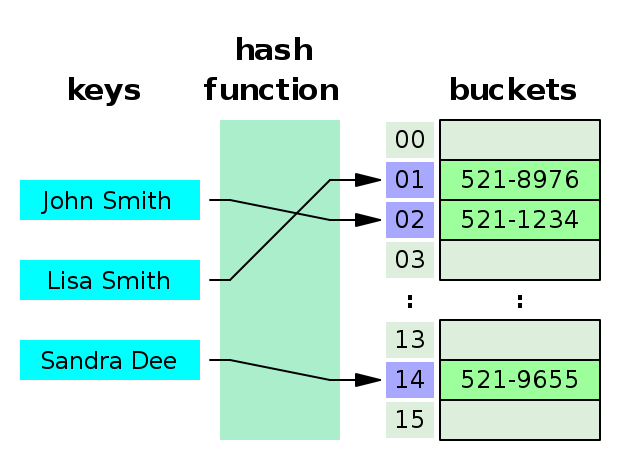
<p>key-value로 이루어진 자료구조 중 하나로 빠르게 데이터를 검색할 수 있는 자료구조</p>

<p>해시 테이블이 빠른 검색 속도를 제공하는 이유 -&gt; 내부적으로 배열(버킷)을 사용하여 데이터를 저장하기 때문.
<br />해시 테이블은 각각의 Key값이 해시함수를 적용해 배열의 고유한 index를 생성하고, 이 index를 생성하고, 이 index를 활용해 값을 저장하거나 검색하게 됨.
<br />(여기서 실제값이 저장된느 장소 -&gt; bucket 또는 slot)
key는 hash 함수를 통해 hash로 변경이 되며 (이 과정을 Hashing이라고 함) hash는 value와 매칭되어 저장소에 저장됨.</p>

<blockquote>
  <h3 id="-hash-table-data-structure-">&lt; Hash Table Data Structure &gt;</h3>
  <ul>
    <li>key : 고유한 값이며, 해시 함수의 input이 됨. 최종 저상소에 저장되면 다양한 길이 만큼의 저장소를 구성해 두어야 하기 때문에 해시 함수로 값을 바꾸어 저장이 되어야 공간의 효율성을 추구할 수 있음.</li>
    <li>해시함수 : key를 hash로 바꿔주는 역할. 다양한 길이를 가지고 있는 key를 일정한 길이를 가지는 hash로 변경하여 저장소를 효율적으로 운영할 수 있도록 도와줌. 
<br /> 단, 서로 다른 key가 같은 hash가 되는 경우 해시충돌(Hash Colllision)이라고 한다. -&gt; 충돌을 일으키는 확률을 최대한 줄이는 함수를 만드는 것이 중요!!</li>
    <li>해시(Hash) : Hash Function의 결과물, 저장소(buckey, slot)에서 값(value)과 매칭되어 저장됨.</li>
    <li>값(Value) : 저장소(bucket, slot)에 최종적으로 저장되는 값으로 키와 매칭되어 저장, 삭제, 검색. 접근이 가능해야 함.
<br />
<br /></li>
  </ul>
</blockquote>

<h2 id="-장단점-">&lt; 장단점 &gt;</h2>
<h3 id="장점">장점</h3>
<p>해시테이블은 Key-Value가 1:1로 매핑되어 있기 때문에 삽입, 삭제, 검색의 과정에서 모두 평균적으로 O(1)의 시간복잡도를 가지고 있음.</p>
<h3 id="단점">단점</h3>
<ul>
  <li>해시 충돌이 발생 (개방 주소법, 체이닝 과 같은 기법으로 해결해줘야함)</li>
  <li>순서/관계가 있는 배열에는 어울리지 않음.</li>
  <li>공간 효율성이 떨어짐. 데이터가 저장되기 전에 저장공간을 미리 만들어야 함. 공간을 만들었지만 공간에 채워지지 않는 경우 발생</li>
  <li>Hash fuction의 의존도가 높음. 해시함수가 복잡하다면 Hash를 만들어 내는데 오래 걸림.
&lt;/br&gt;</li>
</ul>

<p><img src="https://user-images.githubusercontent.com/90206705/148960751-55e0cbdc-2764-4e13-8d00-b144f3eca383.png" alt="img1 daumcdn" /></p>

<p><br />
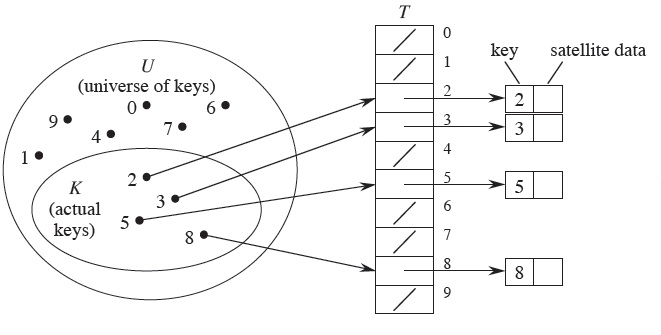
Direct-address table : 키의 전체 개수와 동일한 크기의 bucket을 가진 해시테이블</p>
<blockquote>
  <p>장점 : 키의 개수와 테이블의 크기가 같기 때문에 해시 충돌 문제가 발생하지 않음.
단점 : 전체 키의 개수만큼의 테이블 크기를 유지하는 것은 메모리 낭비일 수 있음.
<br />-&gt; 실제 키 개수보다 적은 해시테이블을 사용하기 때문에 해시 충돌이 발생할 수 밖에 없고, 해시 충돌을 해결하기 위해 다양한 방법들이 고안되었음.
<br /></p>
</blockquote>

<h2 id="해시-충돌">해시 충돌</h2>
<p>A,B 두가지 key가 hash function을 통해 얻은 Hash 값이 똑같을 때
<br />Key-Value가 1:1로 매핑되어야 함</p>

<h3 id="해결방법-1-chaining">해결방법 1. Chaining</h3>

<p><img src="https://user-images.githubusercontent.com/90206705/148962478-eb235e7e-5dc1-4691-b77f-4111c8885365.png" alt="img1 daumcdn" /></p>

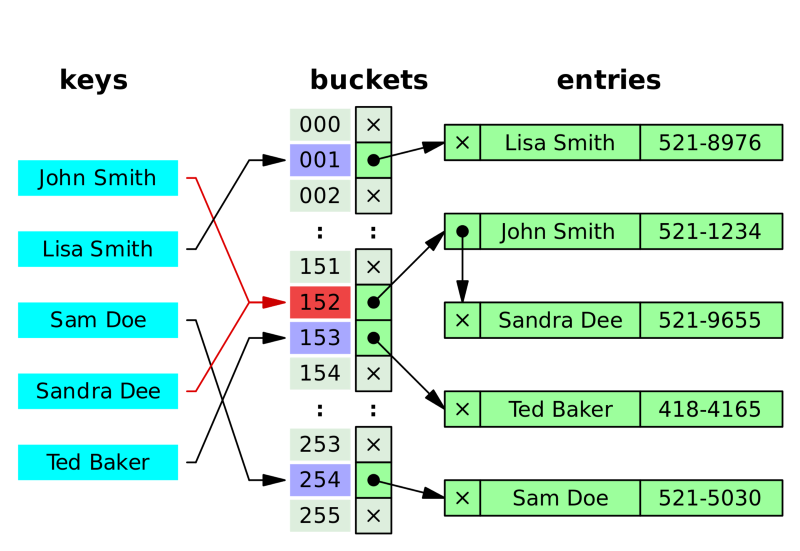
<p><mark>저장소(Bucket)에서 충돌이 일어나면 기존 값과 새로운 값을 연결리스트로 연결하는 방법</mark></p>

<h4 id="장점-1">장점</h4>
<ul>
  <li>미리 충돌을 대비해서 공간을 많이 잡아 놓을 필요가 없음. 충돌이 나면 그때 공간을 만들어서 연결해주면 됨.</li>
</ul>

<h4 id="단점-1">단점</h4>
<ul>
  <li>같은 hash에 자료들이 많이 연결되면 검색시 효율이 낮아짐. Open Addressing은 충돌이 일어나면 비어있는 hash에 데이터를 저장하는 방법이기 때문에 hash table은 hash와 value가 1:1 관계를 유지함.</li>
</ul>

<p>1) 연결리스트를 사용하는 방식 (Linked List)</p>
<ul>
  <li>각각의 bucket들을 연결리스트 (Linked List)로 만들어 Collison이 발생하면 해당 bucket의 list에 추가하는 방식</li>
  <li>삭제 또는 삽입이 간단</li>
  <li>작은 데이터들을 저장할 때 연결 리스트 자체의 overhead가 부담</li>
</ul>

<p>2) Tree를 사용하는 방식 (Red-Black Tree)
트리를 사용하는 방식은 메모리 사용량이 많음.</p>

<h3 id="해결방법-2-개방-주소법-open-addressing">해결방법 2. 개방 주소법 (Open Addressing)</h3>
<p>해시 충돌이 일어나면 다른 버킷에 데이터를 저장하는 방식
1) 선형탐색</p>
<ul>
  <li>해시 충돌시 다음 버킷에 저장하는 방법
2) 제곱 탐색</li>
  <li>해시 충돌시 제곱만큼 건너뛴 버킷에 데이터를 저장하는 방법
3) 이중 해시</li>
  <li>해시 충돌시 다른 해시함수를 한 번 더 적용한 결과를 저장</li>
</ul>

<h4 id="장점-2">장점</h4>
<ul>
  <li>체이닝처럼 포인터가 필요 없고, 지정한 메모리 외에 추가적인 공간이 필요 없음.</li>
  <li>삽입, 삭제시 오버헤드가 적음</li>
</ul>

<h4 id="단점-2">단점</h4>
<ul>
  <li>최악의 경우 비어있는 bucket을 찾지 못하고 탐색을 싲가한 위치까지 되돌아 올 수 있음.</li>
  <li>특정 위치에만 데이터가 몰리는 현상이 나타날 수 있음.</li>
</ul>]]></content><author><name>Jisoo Ryu</name></author><category term="자료구조" /><summary type="html"><![CDATA[]]></summary></entry><entry><title type="html">첫 포스팅</title><link href="https://jisooryu99.github.io//first/" rel="alternate" type="text/html" title="첫 포스팅" /><published>2022-01-11T00:00:00+09:00</published><updated>2022-01-11T00:00:00+09:00</updated><id>https://jisooryu99.github.io//first</id><content type="html" xml:base="https://jisooryu99.github.io//first/"><![CDATA[<h1 id="처음-블로그-작성">처음 블로그 작성</h1>]]></content><author><name>Jisoo Ryu</name></author><summary type="html"><![CDATA[처음 블로그 작성]]></summary></entry></feed>